
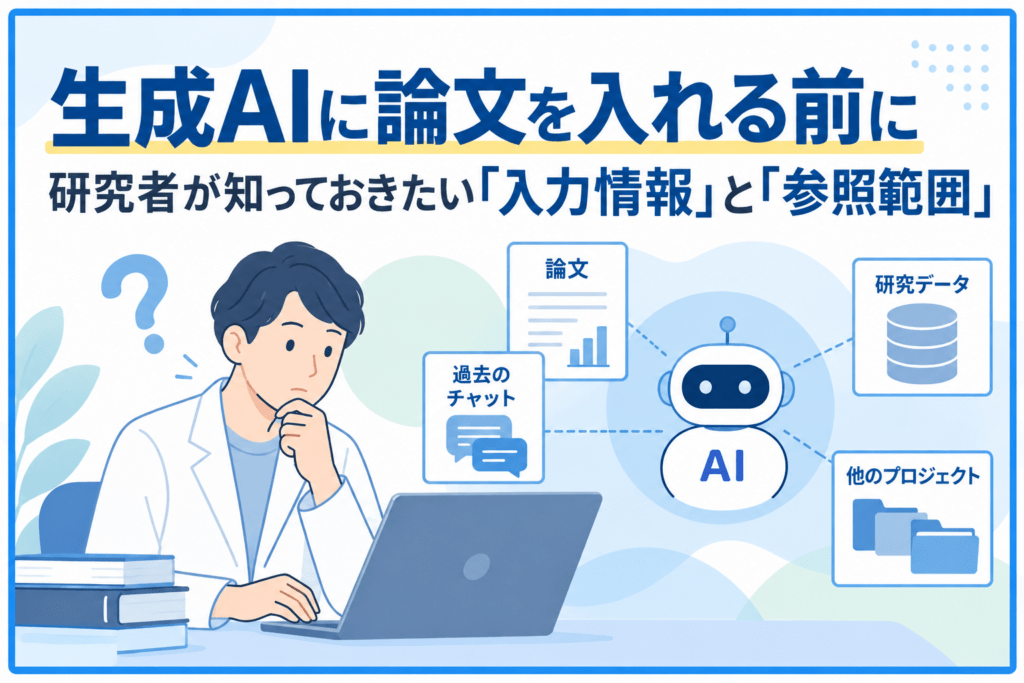
生成AIを論文作成に使うときは、「何を出力させるか」だけでなく、「何をAIに渡しているか」「AIがどの情報を参照できる状態なのか」、そして「入力した情報がどのように扱われるのか」まで意識する必要があります。
ChatGPT、Gemini、Claudeなどの生成AIを、英文の推敲、構成整理、要約、アイデア出しなどに利用する機会は増えています。利用時には「AIの回答が正しいか」「生成された英文に誤りがないか」に注意が向きがちですが、その前段階にも確認しておきたいことがあります。 生成AIは、入力した文章だけをその場で処理しているとは限りません。サービスやプラン、設定によっては、過去の会話、保存された情報、同じプロジェクト内のファイルなどが回答の文脈として利用される場合があります。また、未発表原稿や研究データを入力する場合には、その情報がどのような条件で扱われるのかも確認する必要があります。
1.新しいチャットを開けば「完全に白紙」とは限らない
生成AIには、過去の会話や保存された情報を利用して回答をパーソナライズする機能を持つものがあります。たとえばChatGPTのProjectsには、同じProject内のチャットやファイルを文脈として利用する仕組みがあります。またGeminiにも、設定や利用条件によって過去のチャットを参照してパーソナライズする機能があります。
つまり、「新しいチャットを開いたから、過去の研究とは完全に切り離された」とは限りません。もちろん、すべての生成AIが同じ仕組みを持つわけではなく、参照範囲はサービス、プラン、アカウント種別、設定によって異なります。
たとえば、論文Aについて長期間AIと相談した後、同じ環境で論文Bの原稿を扱う場合、論文Aの条件や用語を論文Bには持ち込みたくないことがあります。そのような場合は、チャットを分けるだけでなく、利用しているAIのメモリ、履歴参照、プロジェクトなどの設定や仕様も確認しておくことが重要です。
2.同じチャットを長く使うと「古い前提」が残ることがある
これはメモリ機能とは別の問題です。同じチャット内でやり取りを続ければ、それまでに伝えた条件は、その後の回答を作るための文脈になります。
たとえば、研究計画の初期段階では「対象はA、主要評価項目はX」としていたものを、途中で「対象はB、主要評価項目はY」に変更したとします。古い条件を含む会話のまま原稿作成を続けると、現在の条件と過去の条件が混在する可能性があります。
研究計画や解析条件が変わったときは、「最新版の原稿」「現在の研究条件」「今回参照してよい資料」を改めて明示することが重要です。場合によっては、新しい前提でチャットや作業環境を分け直した方がよいこともあります。
3.未発表原稿や研究データは「どの条件で扱われるか」を確認する
生成AIを使う際には、出力の品質だけでなく、入力する情報の扱いにも注意が必要です。未発表原稿、未公開データ、共同研究者から受け取った資料、個人を特定できる情報などを扱う場合は、利用するAIサービスの利用規約、データ設定、契約形態などを確認する必要があります。所属機関や共同研究プロジェクトにAI利用ルールがある場合は、それらにも従う必要があります。
重要なのは、「生成AIだから一律に危険」と考えることではありません。同じ生成AIでも、サービスや利用環境によって入力データの保存・利用条件は異なります。論文や研究データを扱う場合には、「何を入力するか」と同時に、「入力した情報がどのように扱われる仕組みなのか」を確認することが大切です。
4.自分の原稿と「他人から預かった原稿」は分けて考える
特に注意したいのが査読中の原稿です。自分の論文を推敲するためにAIを使うことと、査読者として預かった未公開原稿をAIに入力することは、同じ問題ではありません。
Elsevierは、査読中の原稿を機密文書として扱い、ReviewerやEditorが投稿原稿またはその一部を生成AIツールにアップロードしないよう求めています。これは、生成結果の正確性以前に、著者の機密情報や知的財産を外部サービスに渡すことに関わる問題です。
便利かどうかを考える前に、「その情報をAIに入力する権限が自分にあるか」を確認することが必要です。
5.AIに「何を参照してよいか」を明確にする
論文作成では、AIに与える情報源を明確にすることも有効です。複数版の原稿や別研究の資料を扱っている場合には、たとえば「このチャットに添付した最新版の原稿のみを根拠として確認してください。以前の原稿や別の研究の情報は使用しないでください」と指定できます。
ただし、このようにプロンプトで指定することと、システム上ほかの情報から完全に隔離されることは同じではありません。厳密に研究ごとの情報を分離したい場合は、利用中のAIにどのようなメモリ・履歴参照・プロジェクト機能があるのかを確認し、必要に応じて設定や作業環境そのものを分けることが重要です。
「何を生成させるか」だけでなく「何を渡したか」を確認する
生成AIの活用法というと、より良い回答を得るためのプロンプトや、生成された英文の正確性に注目しがちです。しかし、論文作成ではその前に、AIへ渡した情報と、AIが参照できる情報の範囲、さらに入力データがどのように扱われるのかを把握しておく必要があります。
論文ごとに情報を分ける、古い条件を引きずらない、未発表情報の取り扱いを確認する、第三者の機密文書を安易に入力しない。こうした運用上の注意は、AIの性能そのものとは別の問題です。
生成AIを論文作成に利用する際には、「この回答は正しいか?」だけでなく、「この回答は何を材料にして作られたのか?」「その材料をAIに渡してよい条件になっているか?」という視点を持つことも重要です。
NAIでも一部のサービスでAI技術を利用しています
NAIでも、論文の解析、原稿内容の整理、改善点の抽出、ロードマップ作成、翻訳支援、英文表現の分析など、一部のサービスでAI技術を利用しています。AIを利用するサービスについては「AI利用に関する特約」を設け、利用条件やデータの取り扱い、AIの特性、最終確認の責任などを定めています。
特約では、利用者データはサービス提供に必要な範囲に限りAIサービスへ送信される場合があること、また可能な限り利用者データがAIモデルの学習に利用されない契約形態または設定のAIサービスを採用するよう努める方針を定めています。
生成AIは、適切に利用すれば論文作成や投稿準備を効率化できる有用なツールです。重要なのは、AIを使うか使わないかだけで判断するのではなく、どの情報を、どのような条件・環境で扱うのかを理解したうえで利用することです。
参考情報
• OpenAI Help Center, “Projects in ChatGPT”
https://help.openai.com/en/articles/10169521-projects-in-chatgpt
• Google Gemini Apps Help, 「Geminiとの過去のチャットのメモリーを使用してパーソナライズする」
https://support.google.com/gemini/answer/16598469
• Elsevier, “Generative AI policies for journals”
https://www.elsevier.com/about/policies-and-standards/generative-ai-policies-for-journals